Руководство3 мин чтения
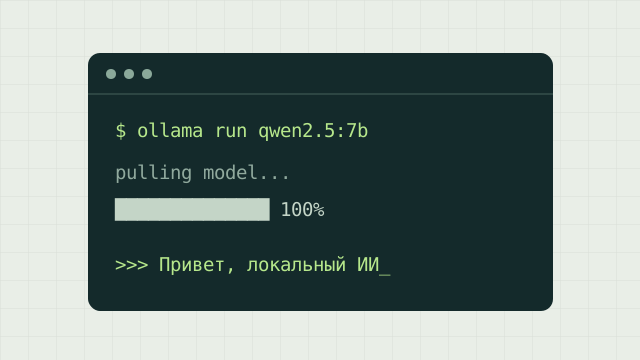
Первая локальная модель с Ollama: от установки до диалога
Установка, первая Qwen3.5, настройка окна и проверка GPU. Команды для повседневной работы.
Установка Ollama и LM Studio, расчёт памяти, исправление OOM и выбор программного стека. Сначала — инструкции для первого запуска.
Установка, первая Qwen3.5, настройка окна и проверка GPU. Команды для повседневной работы.
Где выбрать runtime и GPU Offload, как скачать Qwen3.5 4B и проверить загрузку. Команды lms для повторяемого запуска.
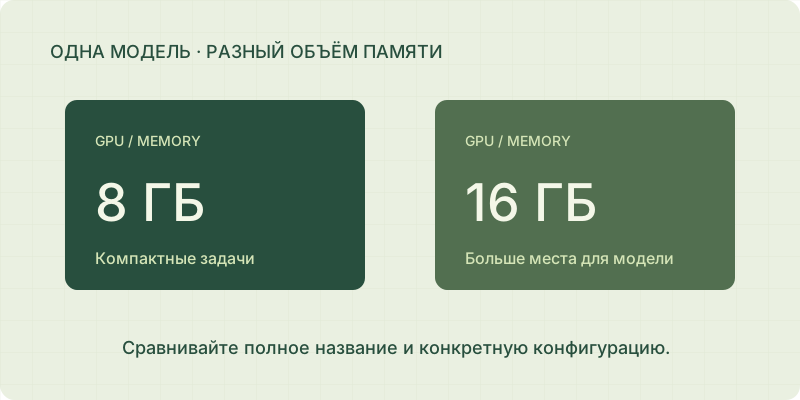
Конкретные сценарии для 8, 16, 24 и 32 ГБ: веса, KV-кэш и резерв считаем отдельно.
Проверяем окно контекста, размещение слоёв, fallback драйвера и журналы. Конкретные настройки Ollama и llama.cpp.
RTX 5060 Ti 8/16 ГБ, настольная RTX 5090 и Laptop GPU, профессиональные карты и исполнения партнёров: что именно сравнивать для локального ИИ.
Три вопроса к обращению через /v1/systemone: отдел, возврат и срочность. Запуск Clef и Clef-Flash, память и вероятности для workflow.
Что изменил релиз 20 октября: поддержка Qwen3.8-Flash-Next, потоковая загрузка экспертов и кэш на SSD. Команды запуска и границы расчёта памяти.
Какие изменения октябрьского SDK полезны владельцу Radeon и Ryzen AI. Проверяем ОС, фактический HIP в приложении и доступную память.
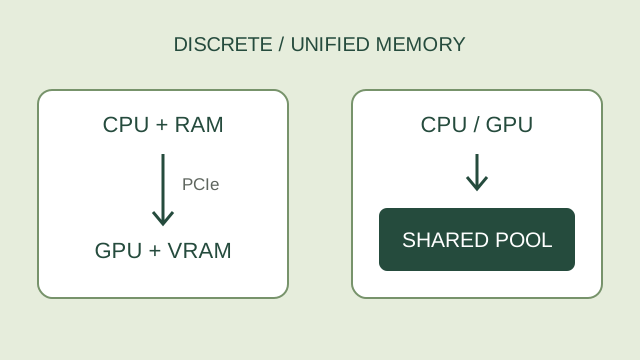
Mac, Strix Halo и DGX Spark: варианты памяти, бюджет GPU и расчёт 64–128 ГиБ. Когда большая MoE полезнее dense 70B и как проверить лимит Metal.
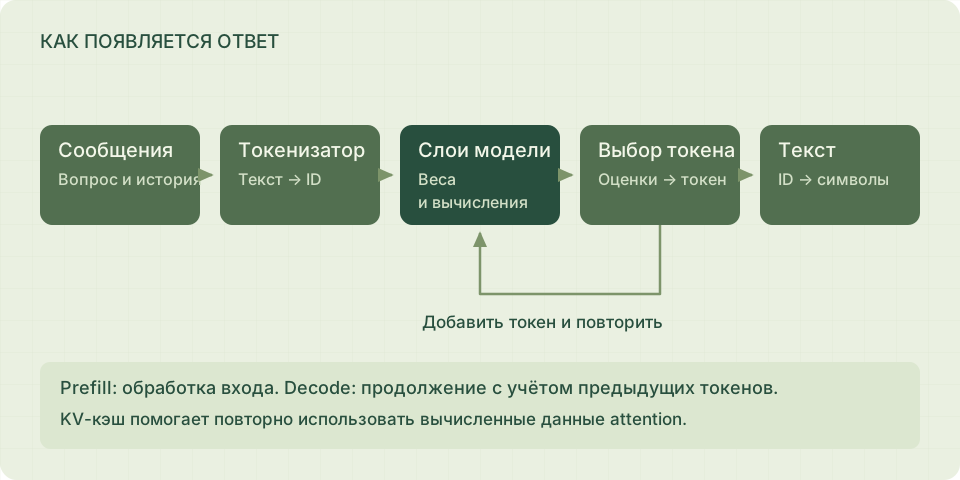
Токенизация, prefill, decode и KV-кэш на примере Qwen3 8B. Где GPU ускоряет вычисления и где заканчивается расчётный потолок.
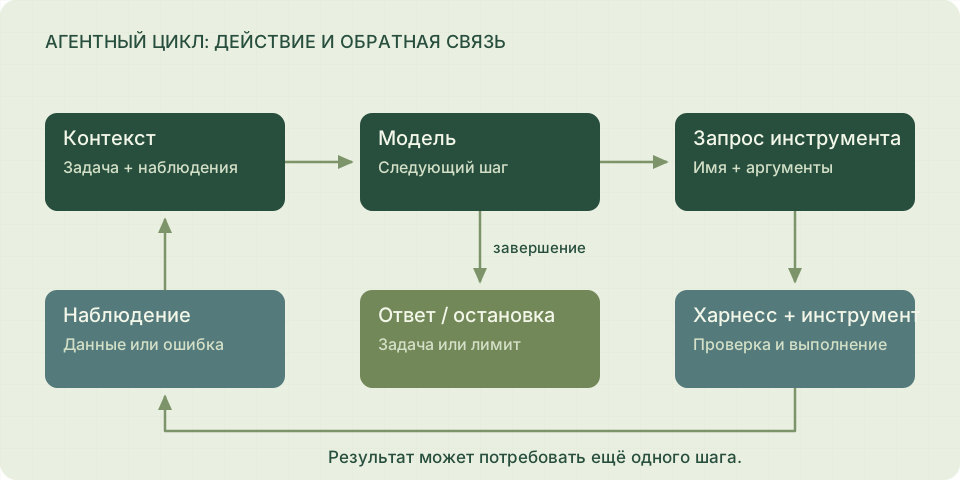
Разбираем запрос инструмента, журнал цикла и память параллельного агента на локальном сервере.
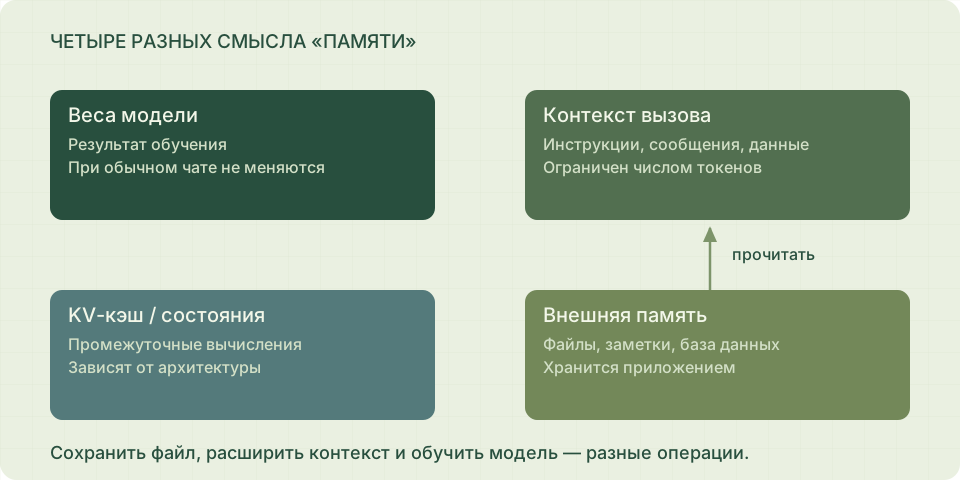
Почему агент теряет детали, сколько кэша добавляют найденные фрагменты и как вынести embeddings на CPU.
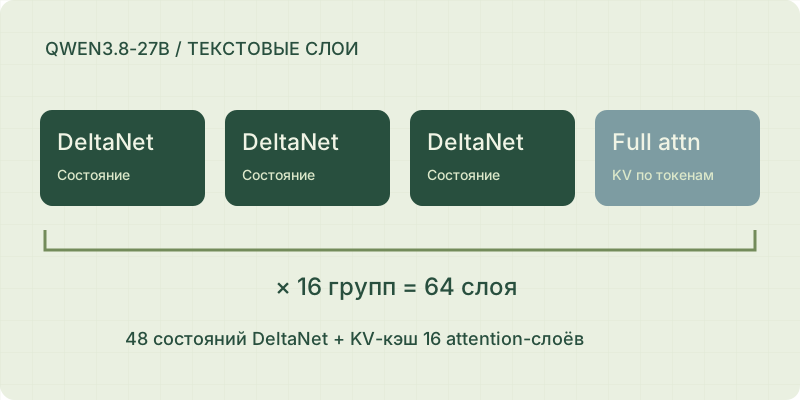
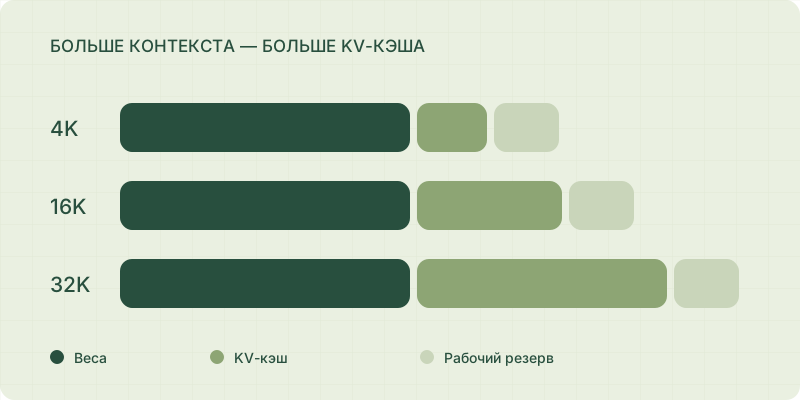
Какое окно помещается на 16, 24, 32 и 96 ГБ; почему короткий контекст ограничивает thinking и как считать гибридный кэш.
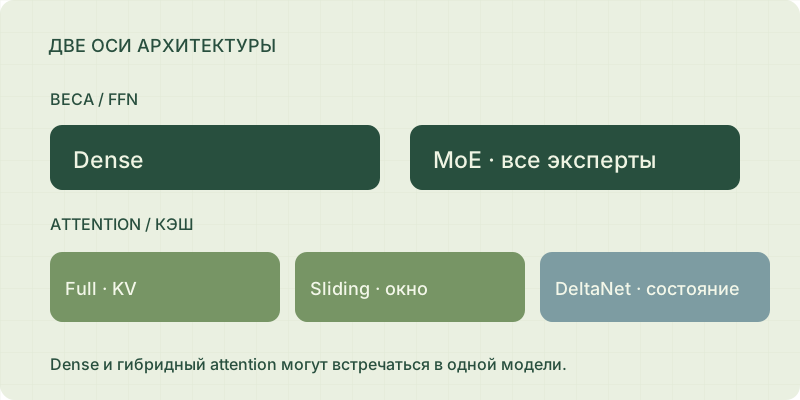
MoE 35B-A3B занимает больше памяти весов, чем dense 27B. Сравниваем конкретные бюджеты и offload экспертов.
Сколько кэша стоит один токен у обычной и гибридной Qwen. Настройки окна и цена параллельных слотов.
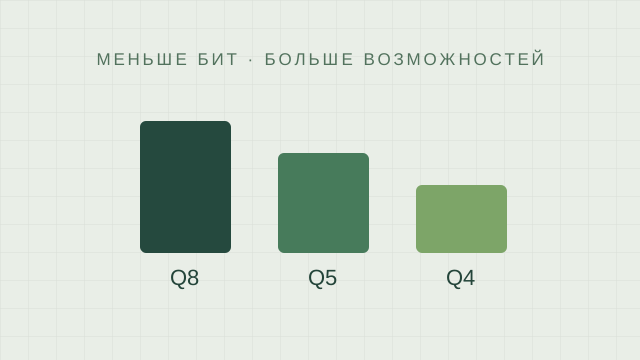
K-кванты, IQ, imatrix, QAT и аппаратные FP8/FP4: что означает название и сколько занимает файл.
Матрица для Radeon в Windows и Linux, runtime LM Studio и текущие требования ComfyUI.
Разделяем обработку промпта, генерацию и загрузку модели. Готовые команды llama-bench и Ollama.
SDXL, FLUX и Wan: размеры компонентов, режимы VRAM и команды для диагностики.