Что входит в окно
Инструкции, история, документы, результаты инструментов, рассуждение и ответ делят одно окно. Число токенов определяет токенизатор; 500 слов и 500 токенов — разные длины. Если приложению не хватает окна, оно может исключать ранние сообщения или заменять их резюме.
Формула и стоимость токена
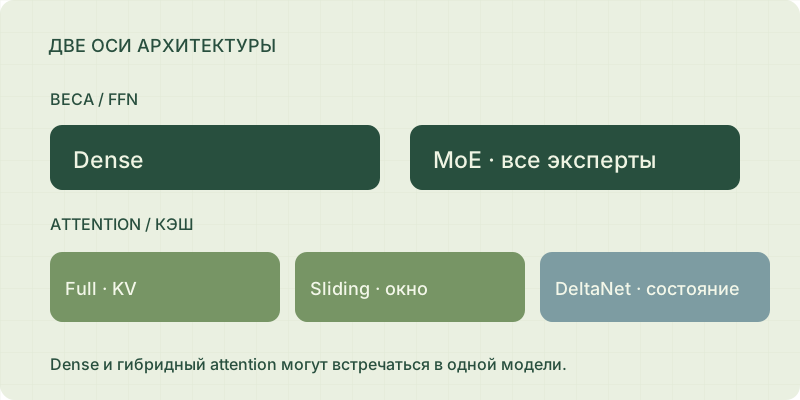
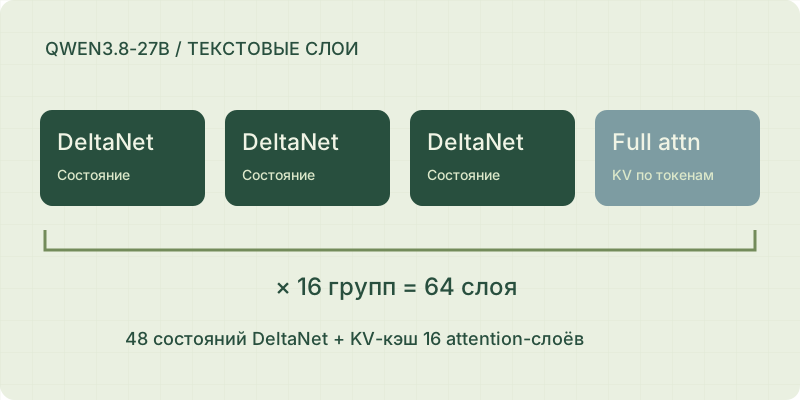
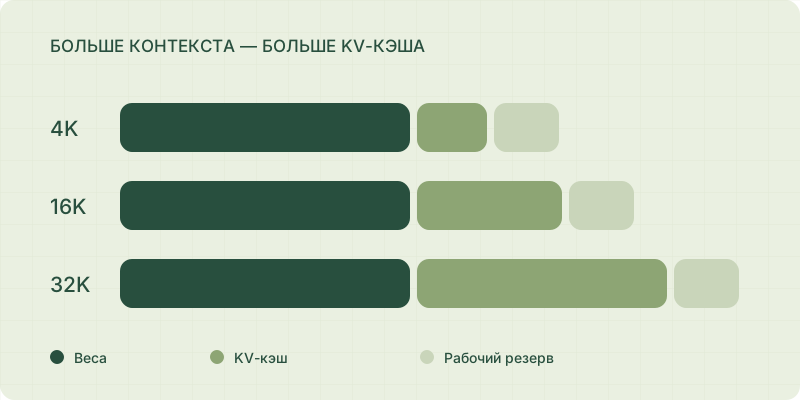
Обычный KV: 2 × attention-слои × KV-головы × размер головы × токены × байты. У Qwen3 32B FP16 получается 256 КиБ/токен, у Qwen3.8 27B — 64 КиБ/токен. В гибриде формула применяется только к full-attention слоям, состояния DeltaNet добавляются отдельно.
| Контекст | Qwen2.5 32B | Qwen3 32B | Qwen3.8 27B | Состояния Qwen3.8 |
|---|---|---|---|---|
| 4K | 1,0 ГиБ | 1,0 ГиБ | 0,25 ГиБ | 0,14 ГиБ |
| 8K | 2,0 ГиБ | 2,0 ГиБ | 0,5 ГиБ | 0,14 ГиБ |
| 16K | 4,0 ГиБ | 4,0 ГиБ | 1,0 ГиБ | 0,14 ГиБ |
| 32K | 8,0 ГиБ | 8,0 ГиБ | 2,0 ГиБ | 0,14 ГиБ |
Как задать окно
Ollama выбирает исходное окно по VRAM: менее 24 ГиБ — 4K, от 24 до менее 48 ГиБ — 32K, от 48 ГиБ — 256K. Проверьте столбцы CONTEXT и PROCESSOR командой ollama ps. Задать своё окно можно ползунком в настройках приложения, через OLLAMA_CONTEXT_LENGTH у сервера или /set parameter num_ctx 8192 внутри чата CLI.
llama-server -m model.gguf -c 8192Переменная OLLAMA_CONTEXT_LENGTH относится к серверу; настройка для Windows и systemd дана в первом запуске. У llama.cpp -c задаёт размер контекста. Проверьте выделенные буферы в журнале после загрузки.
Параллельность и квантование
Два независимых слота Qwen3 8B по 8K требуют 2,25 ГиБ обычного KV вместо 1,13 ГиБ для одного. В Ollama бюджет контекста растёт с OLLAMA_NUM_PARALLEL. У гибридов отдельно копируются состояния последовательностей.
Квантование кэша — отдельная настройка от Q4 весов. Для 32K Qwen3 32B расчёт FP16 даёт 8,0 ГиБ, Q8 — 4,25 ГиБ. Учтена блочная надбавка; это не ровно половина. Команды и условия Flash Attention.
Что изменить для документов
- Оставьте место под ответ и thinking.
- Передавайте найденные фрагменты с названием файла и страницей.
- Уберите неиспользуемые инструменты и повторяющиеся инструкции.
- Сравните время обработки входа и пиковую память при целевой длине документа.
Как устроить RAG · Рассчитать своё окно. Таблица — бюджет хранения, без vision/MTP и пика prefill.
Источники и документация
- Qwen2.5 32B Instruct: конфигурация ↗
- Qwen3 32B: конфигурация ↗
- Qwen3.8 27B: конфигурация ↗
- Qwen3 8B: конфигурация ↗
- Ollama: контекст по объёму VRAM ↗
- Ollama: настройки, кэш, хранение моделей ↗
- llama.cpp: параметры сервера ↗
Сведения и документация проверены 24.10.2026.