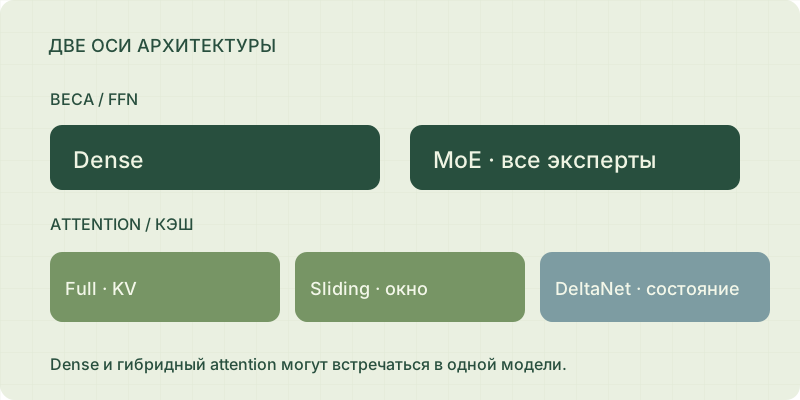
Две независимые оси
Dense/MoE описывают устройство вычислительных блоков и выбор экспертов; full/sliding/DeltaNet — механизм внимания и хранение данных между шагами. Dense-модель тоже может быть гибридной по attention. Число активных параметров влияет на работу токена, а память полного размещения включает все веса.
35B-A3B против dense 27B
| Модель | Веса | KV | Состояния | Всего |
|---|---|---|---|---|
| Qwen3.8 27B | 15,4 ГиБ | 0,5 ГиБ | 0,14 ГиБ | 17,55 ГиБ |
| Qwen3.6 35B-A3B | 19,97 ГиБ | 0,16 ГиБ | 0,06 ГиБ | 21,68 ГиБ |
| Qwen3 30B-A3B | 17,4 ГиБ | 0,75 ГиБ | 0,0 ГиБ | 19,65 ГиБ |
Qwen3.6 35B-A3B использует около 3B активных параметров на токен, но хранить нужно все 35B. Поэтому её веса больше dense 27B. Фраза «читает только 3B» тоже упрощает картину: маршрутизация и общие блоки остаются, а реальный трафик определяет движок.
Если эксперты остаются в RAM
llama-server -m model.gguf -c 8192 -ngl auto --cpu-moe--cpu-moe оставляет все MoE-веса на CPU; --n-cpu-moe N оставляет экспертов первых N слоёв. Это число слоёв, а не экспертов. Параметры экономят VRAM, но выводят расчёт за пределы таблицы полного размещения. Скорость теперь включает работу CPU, пропускную способность RAM и обмен между устройствами. Сравнивайте pp и tg на своей конфигурации.
Сколько стоит токен у разных attention
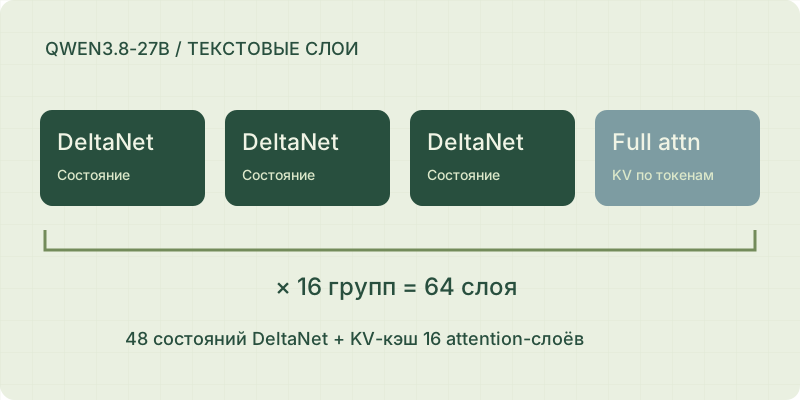
FP16 KV у Qwen3 32B — 256 КиБ/токен, у Qwen3.8 27B — 64 КиБ/токен. На 32K это 8,0 ГиБ и 2,0 ГиБ соответственно. У гибрида дополнительно 0,14 ГиБ состояния.
Sliding attention может хранить только локальное окно или весь контекст. У gpt-oss-20b на 8K FP16 эти варианты дают 0,19 ГиБ и 0,38 ГиБ обычного KV. Устройство кэша нужно знать до переноса формулы.
gpt-oss: почему native — отдельный профиль
В официальном индексе gpt-oss-20b размер всех упакованных тензоров — 13 761 264 768 байт, или 12,82 ГиБ. MoE-тензоры MXFP4 и остальные тензоры хранятся по-разному, поэтому здесь нельзя подставить «всё × 4 бита». Калькулятор фиксирует native и отдельно переключает sliding-кэш.
Распаковка или перекладка весов меняет расход VRAM. Это оценка хранения без vision/MTP, дополнительных копий состояний и пика prefill. Для новых архитектур сначала нужны конфигурация, типы тензоров и устройство кэша. Модели без численного пресета.
Источники и документация
- Qwen3.8 27B: конфигурация ↗
- Qwen3.6 35B-A3B: конфигурация ↗
- Qwen3 30B-A3B: конфигурация ↗
- Qwen3 32B: конфигурация ↗
- gpt-oss-20b: конфигурация ↗
- gpt-oss-20b: размер тензоров ↗
- Qwen3.6 35B-A3B: карточка ↗
- llama.cpp: параметры сервера ↗
- Transformers: состояния DeltaNet ↗
- Transformers: типы кэша ↗
Сведения и документация проверены 24.10.2026.