Q4_K_M — рецепт смешанного хранения
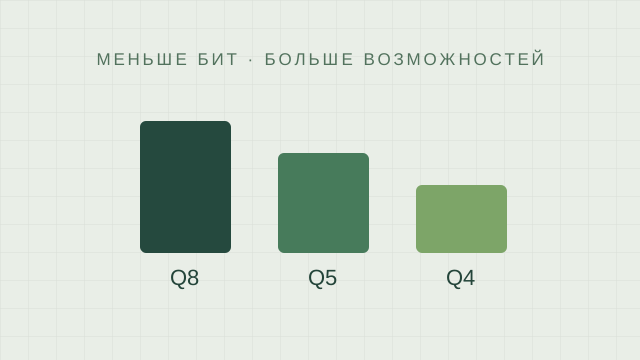
GGUF — контейнер. Q4_K_M — схема квантования: блочные K-кванты хранят значения и масштабы, а часть важных тензоров получает более высокую точность. Поэтому Q4 не означает ровно четыре бита на каждый параметр. Суффиксы S/M описывают варианты распределения точности; их нужно сравнивать на одной модели и у одного издателя.
IQ-кванты используют другие, в том числе нелинейные, схемы кодирования. Их поддержка и скорость определяются реализацией движка, а не только числом в имени файла.
Что делает imatrix и чем отличается QAT
llama-imatrix собирает важность весов на калибровочном тексте; llama-quantize --imatrix использует эти данные при квантовании. Это дополнительный этап подготовки файла. QAT — quantization-aware training: влияние квантования учитывают во время обучения или дообучения. Готовый Q4-файл не становится QAT-моделью из-за названия формата.
У калибровки есть предметная область: файл, подготовленный на одном наборе данных, оценивайте на своих текстах. Сохраните несколько одинаковых запросов и сравните полноту ответа, код и повторения.
Реальные файлы: Qwen3.5 4B
| Квант | Размер на HF |
|---|---|
| Q4_K_M | 2,74 ГБ |
| Q5_K_M | 3,14 ГБ |
| Q8_0 | 4,48 ГБ |
Это размеры 2,74 / 3,14 / 4,48 десятичных ГБ, опубликованные издателем файлов; mmproj скачивается отдельно. Разница между Q4 и Q5 здесь — около 0,40 ГБ на диске. Для VRAM добавьте кэш и буферы. Нельзя переносить эти размеры на одноимённый пакет Ollama или другого автора квантования.
MXFP4, FP8 и NVFP4
gpt-oss использует смешанное хранение: MXFP4 у MoE-тензоров и другие форматы у остальной сети. Его native-профиль в калькуляторе берётся из индекса тензоров. MXFP4 и NVFP4 — разные форматы масштабирования FP4. FP8 также имеет варианты представления; файл FP8 не обещает аппаратного FP8-вычисления на любом GPU.
NVFP4 рассчитан на поддерживающий его стек Blackwell. В ComfyUI отдельно выбираются хранение весов и режим вычислений; флаг хранения FP8 не добавляет старой карте новые Tensor-ядра. Пример настройки и последствия — в руководстве по ComfyUI.
Порядок выбора
- Выберите поддержанный вашим движком файл одной модели.
- Посчитайте целевое окно в калькуляторе.
- Сравните Q4 и Q5 на одинаковых вопросах; Q8 пробуйте, если хватает памяти.
- Запишите издателя, ревизию, квант и фактический расход памяти.
Расчёт средней битности не заменяет размер конкретного файла и его размещение в памяти.
Источники и документация
- llama.cpp: квантование ↗
- llama.cpp: imatrix ↗
- llama.cpp: выбор типов тензоров ↗
- Unsloth: размеры Qwen3.5 4B ↗
- NVIDIA Model Optimizer: QAT и форматы ↗
- gpt-oss-20b: конфигурация ↗
- gpt-oss-20b: размер тензоров ↗
- ComfyUI: параметры командной строки ↗
Сведения и документация проверены 24.10.2026.