Почему видимый чат длиннее входа модели
На 16-ГБ карте Ollama по умолчанию выделяет 4K контекста, на 24-ГБ — 32K. Полный чат в интерфейсе может быть длиннее: приложение удаляет ранние сообщения или передаёт их резюме. Потерянные при сокращении числа и условия не появятся в ответе сами. Проверьте CONTEXT в ollama ps, задайте окно явно и сохраните важные факты вне диалога.
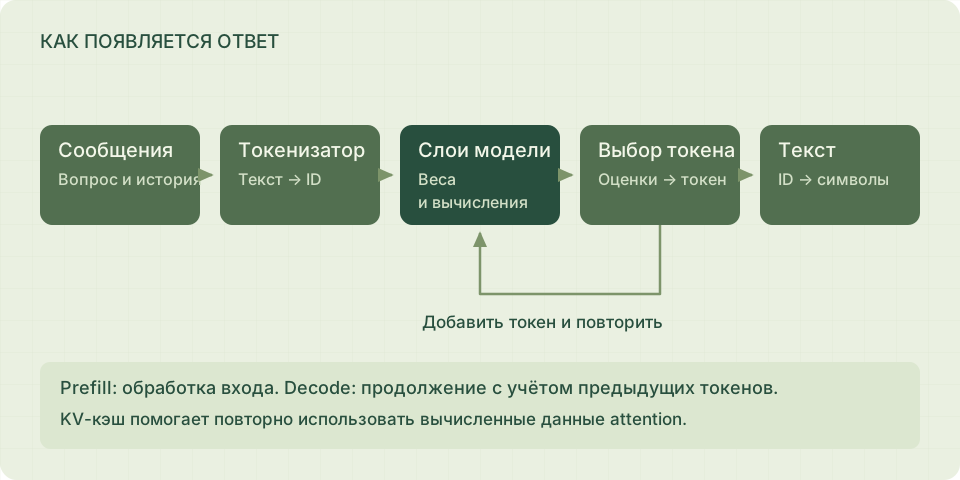
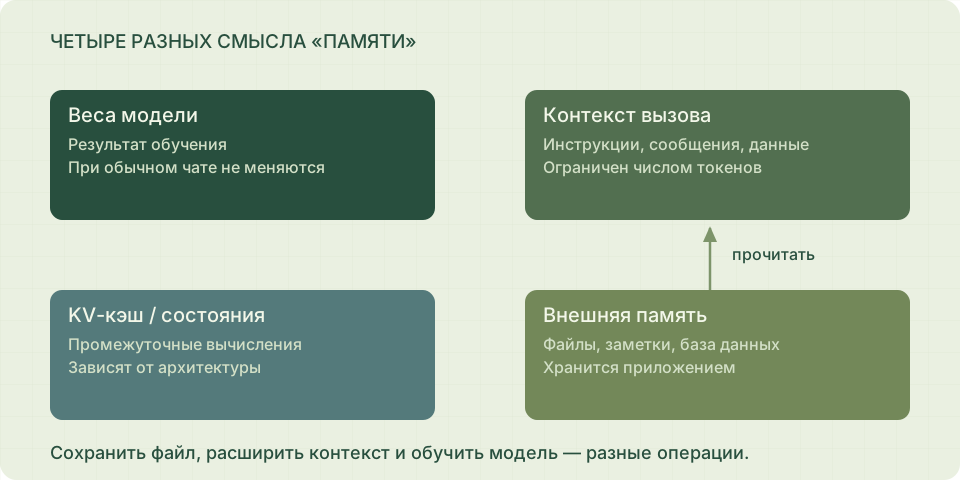
Схема разных видов памяти уже есть в разделе принципов. KV-кэш — рабочие тензоры, не архив; история и исходные документы хранятся средствами приложения.
RAG: передайте меньше, но с источниками
При подготовке документы разбивают на фрагменты и индексируют. Во время запроса поиск выбирает подходящие фрагменты; приложение добавляет их к вопросу перед генерацией. Десять фрагментов по 500 токенов дают 5000 токенов, ещё до инструкций и ответа. У Qwen3 8B FP16 это 0,69 ГиБ KV для этих токенов.
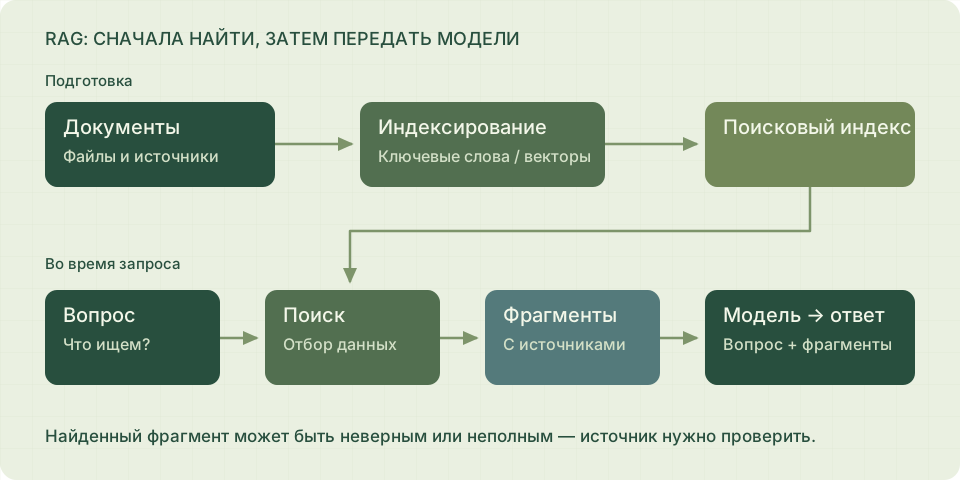
RAG не исправляет неверный поиск. Для каждого фрагмента сохраняйте файл, страницу, дату и точную выдержку; проверяйте, что ответ действительно опирается на этот текст. Короткий документ можно передать целиком без отдельного векторного индекса.
Embedding-модель: отдельная нагрузка
| Модель | Файл весов | Назначение |
|---|---|---|
| all-MiniLM-L6-v2 | model.safetensors, 90,9 МБ | Компактный англоязычный пример |
| BAAI bge-m3 | pytorch_model.bin, 2,27 ГБ | Многоязычный поиск; более крупная модель |
Размер файла не равен пику памяти сервиса. Embeddings можно считать на CPU и держать индекс в RAM/на диске, освобождая VRAM основной LLM. Например, в Sentence Transformers:
from sentence_transformers import SentenceTransformer
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2", device="cpu")
Для русского корпуса проверьте многоязычную модель на собственных вопросах; компактный английский пример не является рекомендацией для любого языка.
Навык, MCP и долговременные заметки
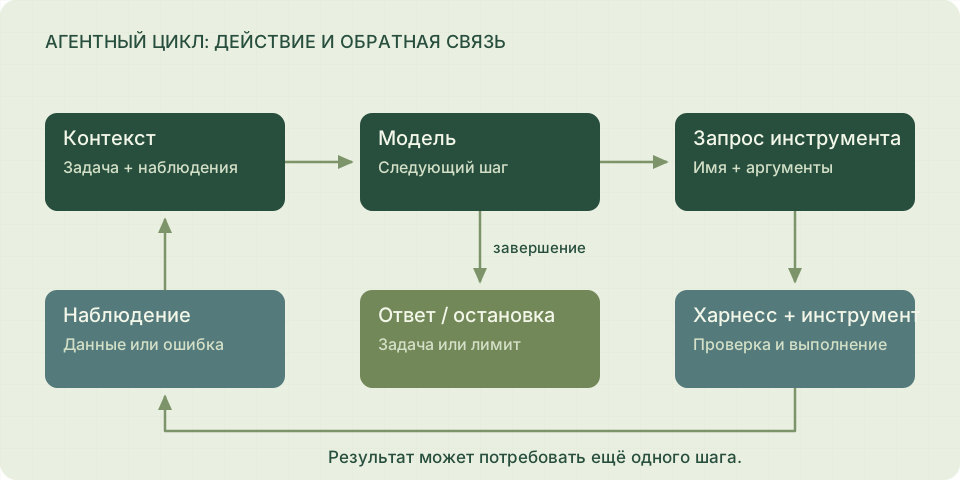
Навык Agent Skills содержит SKILL.md с инструкциями и может включать скрипты и справочные материалы. MCP задаёт обмен с инструментами и ресурсами. Их короткие определения — в словаре. В RAG-процессе навык может описывать проверку источника, MCP-инструмент — выполнять поиск, а харнесс — выбирать, какие результаты попадут во вход.
Для долгой задачи сохраняйте отдельно цель, подтверждённые факты, незаконченные шаги и ссылки на первичные файлы. Перед следующим сеансом перечитайте нужные записи; это управление контекстом, а не дообучение.
Источники и документация
- LM Studio: документы в контексте и RAG ↗
- Justin Young, Anthropic: Effective harnesses for long-running agents, 26.11.2025 ↗
- Agent Skills: инструкции, ресурсы и загрузка по необходимости ↗
- Model Context Protocol: обзор архитектуры ↗
- Ollama: контекст по объёму VRAM ↗
- Hugging Face Transformers: как работает KV-кэш ↗
- Qwen3 8B: конфигурация ↗
- MiniLM: карточка ↗
- MiniLM: файл ↗
- BGE-M3: карточка и файлы ↗
- Sentence Transformers: CPU ↗
Сведения и документация проверены 24.10.2026.