Сначала модель и задача, затем тип памяти
Когда веса с кэшем выходят за 24–32 ГБ, большой общий пул позволяет держать модель без разделения между дискретной VRAM и RAM. Если модель уже помещается на карте, выбирать систему стоит по времени ответа и поддержке приложений.
Здесь официальные характеристики и расчёты, собственных замеров нет. Таблица: одна текстовая последовательность, все языковые веса, KV FP16, резерв 8 ГиБ на ОС и буферы; vision, MTP, обучение и пик prefill исключены. Резерв и объём RAM не гарантируют доступный GPU-бюджет. Потолок dense decode предполагает чтение всех весов один раз на токен при полной паспортной полосе, без трафика KV, распаковки, вычислений и ОС; он не является универсальной границей при кэшировании, batching или speculative decoding.
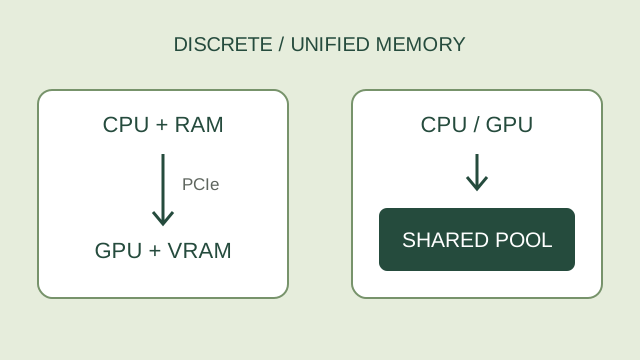
Что означает общая память
CPU и GPU этих SoC используют одну физическую память. Выделенные 96 ГБ графике на 128-ГБ Strix Halo берутся из того же пула: 128 + 96 складывать нельзя. ОС, приложения, веса и кэш делят общий бюджет. «Общая память GPU» у дискретной GeForce в Windows означает другой путь доступа к системной RAM.
В спецификациях — ГБ и ГБ/с производителей; расчёты хранения — в ГиБ, где 1 ГиБ = 2³⁰ байт.
Официальные конфигурации: не смешивайте варианты
| Исполнение | Память | Полоса, ГБ/с | Уточнение |
|---|---|---|---|
| MacBook Pro M4 Max, GPU 40 ядер ↗ | 48, 64 или 128 ГБ общей памяти | 546 | 32 ядра GPU: 410 ГБ/с и только 36 ГБ. Память 48–128 ГБ — с 40 ядрами GPU. |
| MacBook Pro M5 Max, GPU 40 ядер ↗ | 48, 64 или 128 ГБ общей памяти | 614 | 32 ядра GPU: 460 ГБ/с и только 36 ГБ. Память 48–128 ГБ — с 40 ядрами GPU. |
| Ryzen AI Max+ 395 / Radeon 8060S ↗ | До 128 ГБ LPDDR5x; до 96 ГБ под GPU через VGM | 256 | 256 бит × 8000 МТ/с / 8 = 256 ГБ/с; расчёт пика интерфейса, не замер. |
| NVIDIA DGX Spark 128 ГБ / GB10 ↗ | 128 ГБ LPDDR5x, общий когерентный пул | 273 | Blackwell GPU и Arm CPU. Для отдельной конфигурации 64 ГБ NVIDIA указала начало поставок OEM-партнёров 23.10.2026. |
Для AMD пик вычислен как 256 бит × 8000 МТ/с / 8 = 256 ГБ/с; AMD указывает такую же полосу у Ryzen AI Halo RAH-001. Профиль Spark здесь — 128 ГБ; OEM-конфигурация 64 ГБ рассматривается отдельно.
Сколько памяти действительно выделяется GPU
AMD VGM позволяет выделить до 96 ГБ GPU из 128 ГБ. В отдельном Linux-примере AMD на Framework Desktop, Ubuntu 24.04.3, TTM/GTT настроены до 120 ГБ на узел.
Ryzen AI Max+ 395 / Radeon 8060S (gfx1151) присутствует в матрице ROCm 10.1.0; для Windows указана Windows 11 25H2. Исправление HIP OOM при переходе в общий пул нужно проверять в конкретном приложении: версия HIP и путь Vulkan на Windows.
На Mac смотрите recommendedMaxWorkingSetSize в журнале запуска llama.cpp с Metal: движок печатает значение в MB. Это рекомендованный Metal размер рабочего набора для устройства, а не вся установленная RAM и не жёсткий предел всех выделений. Учтите текущую нагрузку и план размещения движка. На Spark также проверяйте фактически свободный пул после запуска системы.
Что помещается в 64, 96 и 128 ГиБ
| Модель / веса / контекст | Веса, ГиБ | KV + состояния, ГиБ | Всего с резервом 8 ГиБ | Пул 64 ГиБ | Пул 96 ГиБ | Пул 128 ГиБ |
|---|---|---|---|---|---|---|
| gpt-oss-120b · native (MXFP4) · 8K | 60,77 | 0,29 | 69,05 ГиБ | Не помещается | В бюджете | В бюджете |
| gpt-oss-120b · native (MXFP4) · 32K | 60,77 | 1,13 | 69,9 ГиБ | Не помещается | В бюджете | В бюджете |
| gpt-oss-120b · native (MXFP4) · 128K | 60,77 | 4,5 | 73,27 ГиБ | Не помещается | В бюджете | В бюджете |
| Qwen3.8 27B · Q4_K_M · 256K | 15,4 | 16,14 | 39,55 ГиБ | В бюджете | В бюджете | В бюджете |
| Qwen3.6 35B-A3B · Q4_K_M · 256K | 19,97 | 5,06 | 33,03 ГиБ | В бюджете | В бюджете | В бюджете |
| Llama 3.1 70B Instruct · Q4_K_M · 32K | 40,27 | 10,0 | 58,27 ГиБ | В бюджете | В бюджете | В бюджете |
| Llama 3.1 70B Instruct · Q4_K_M · 64K | 40,27 | 20,0 | 68,27 ГиБ | Не помещается | В бюджете | В бюджете |
| Llama 3.1 70B Instruct · Q4_K_M · 128K | 40,27 | 40,0 | 88,27 ГиБ | Не помещается | В бюджете | В бюджете |
| Llama 3.1 70B Instruct · Q8_0 · 8K | 69,86 | 2,5 | 80,36 ГиБ | Не помещается | В бюджете | В бюджете |
| Llama 3.1 70B Instruct · Q8_0 · 64K | 69,86 | 20,0 | 97,86 ГиБ | Не помещается | Не помещается | В бюджете |
| Llama 3.1 70B Instruct · Q8_0 · 128K | 69,86 | 40,0 | 117,86 ГиБ | Не помещается | Не помещается | В бюджете |
Колонки — условные доступные бюджеты в ГиБ; 96 ГиБ не обозначают комплектацию MacBook Pro. Ссылки открывают те же параметры в калькуляторе.
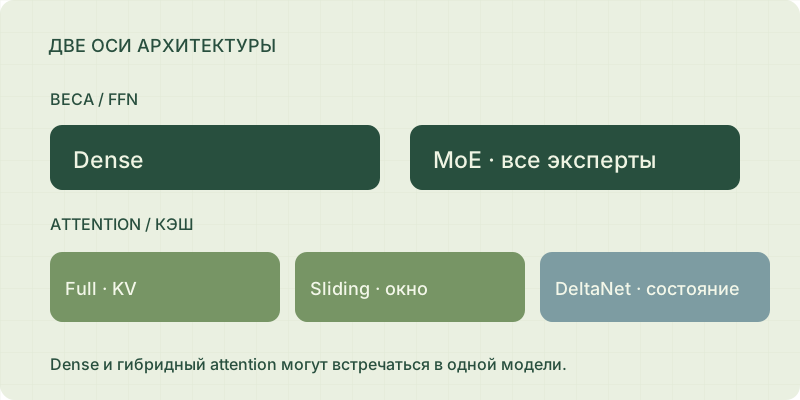
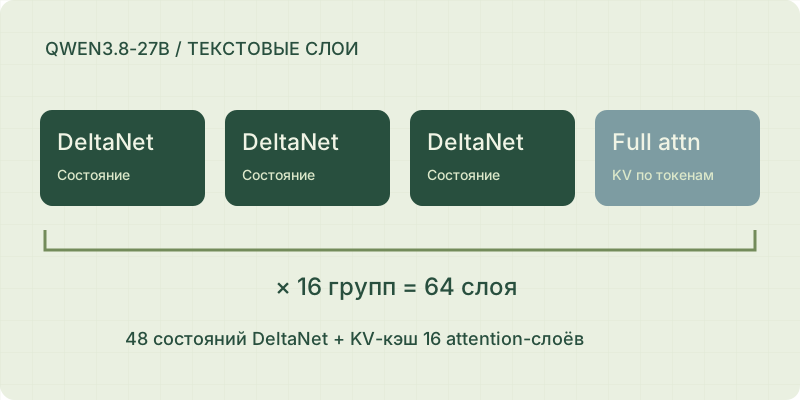
Выберите колонку по реально доступному бюджету GPU. У Qwen3.8 KV растёт только на full-attention слоях; состояния DeltaNet учитываются отдельно. Для MoE нужны веса всех экспертов. Архитектуры и память.
Почему вместимость не равна скорости
Для dense decode одного потока упрощённая оценка: токенов/с ≤ байт/с памяти / байты весов.
В примере dense Llama 3.1 70B Q4_K_M оценка весов — 40,27 ГиБ, то есть 43,24 десятичных ГБ. KV и резерв входят в таблицу вместимости, но не в знаменатель этой упрощённой формулы:
| Платформа | Полоса, ГБ/с | B / W, токенов/с |
|---|---|---|
| MacBook Pro M4 Max, GPU 40 ядер | 546 | 12,63 |
| MacBook Pro M5 Max, GPU 40 ядер | 614 | 14,2 |
| Ryzen AI Max+ 395 / Radeon 8060S | 256 | 5,92 |
| NVIDIA DGX Spark 128 ГБ / GB10 | 273 | 6,31 |
Для Strix Halo и Spark это около 6 токенов/с по трафику весов dense 70B Q4. Дополнительные затраты перечислены в начале. Prefill обрабатывает вход иначе: проверяйте pp и время первого токена отдельно.
Большая MoE: расчёт gpt-oss-120b
OpenAI описывает размещение gpt-oss-120b на одной GPU с 80 ГБ. В официальной model card — 116,83B параметров всего и около 5,1B активных на токен (5,13B с unembedding). Упаковка экспертов MXFP4 помогает вместить весь набор; активные параметры определяют лишь часть работы каждого шага.
Поэтому большая MoE — естественный кандидат для системы на 128 ГБ с полосой 256–273 ГБ/с: хранить нужно всех экспертов, а за токен читается выбранная часть. Для MoE деление на все веса некорректно описывает скорость; потолок dense 70B из предыдущего раздела к ней не переносится. Это редакционный вывод из архитектуры, без обещания tok/s на Mac, Strix Halo или Spark. Таблица выше показывает gpt-oss-120b при 8K, 32K и 128K: исходные упакованные веса из официального индекса и sliding-кэш окна 128. Это основной MoE-сценарий для пулов 96/128 ГиБ. Ссылки открывают пресет калькулятора; окно и поддержку MXFP4 проверяйте в движке. Распаковка весов может увеличить расход.
Программный стек: GGUF, CUDA и ComfyUI
Mac: Metal в llama.cpp/Ollama или отдельный MLX-путь; ComfyUI поддерживает Apple Silicon.
Strix Halo: Vulkan в Ollama/llama.cpp либо HIP с согласованным ROCm. Max+ 395 есть в Linux-списке ROCm Ollama; на Windows начните с Vulkan.
DGX Spark: CUDA на Blackwell и Arm CPU, поэтому нужны соответствующие пакеты. NVIDIA публикует ComfyUI playbook для Spark. Проверьте используемые custom nodes на выбранной платформе.
Как сравнить перед покупкой
- Запишите модель, формат весов, окно, число диалогов и доступный GPU-бюджет; задайте их в калькуляторе.
- На одинаковой модели сравните загрузку, pp, время первого токена и tg после заполнения окна по методике.
- Для ComfyUI проверьте полный workflow и пик памяти; для агента — реальную длину входа и параллельность.
- Сопоставьте с дискретными картами и сводкой обзоров. Общая память означает выбор компьютера целиком.
Источники и документация
- Apple: MacBook Pro 16″ 2024, варианты M4 Max ↗
- Apple: актуальные варианты M5 Max ↗
- Apple, 03.03.2026: анонс M5 Pro / Max ↗
- AMD: Ryzen AI Max+ 395, интерфейс и объём памяти ↗
- AMD: Variable Graphics Memory и 96 ГБ ↗
- AMD: Ryzen AI Halo RAH-001, 256 ГБ/с ↗
- AMD: Framework Desktop, Ubuntu и расширение TTM/GTT ↗
- NVIDIA: DGX Spark 128 ГБ, GB10 и полоса памяти ↗
- NVIDIA: OEM-вариант DGX Spark 64 ГБ ↗
- NVIDIA, 02.10.2026, Allen Bourgoyne: поставки OEM-конфигурации 64 ГБ с 23 октября ↗
- NVIDIA: prefill/decode, трафик и roofline ↗
- Ollama: аппаратная поддержка и бэкенды ↗
- llama.cpp: Metal, Vulkan и HIP ↗
- AMD, 05.10.2026: исправление HIP OOM на Windows APU ↗
- AMD: совместимость ROCm 10.1.0 ↗
- ComfyUI: системные требования ↗
- Ollama 0.30: MLX и GGUF как разные пути загрузки ↗
- Meta: параметры Llama 3.1 70B Instruct ↗
- NVIDIA: ComfyUI на DGX Spark ↗
- OpenAI: gpt-oss на одной GPU 80 ГБ ↗
- OpenAI: параметры gpt-oss-120b, официальная model card ↗
- OpenAI: карточка gpt-oss-120b ↗
- Apple: recommendedMaxWorkingSetSize ↗
- Apple: рабочий набор Metal и выделения сверх него ↗
- llama.cpp: печать рекомендованного Metal-бюджета ↗
- gpt-oss-120b: конфигурация ↗
- gpt-oss-120b: размер тензоров ↗
- Qwen3.8 27B: конфигурация ↗
- Qwen3.6 35B-A3B: конфигурация ↗
- Llama 3.1 70B Instruct: конфигурация ↗
Сведения и документация проверены 25.10.2026.