Что меняет версия 1.4.0
В Splash 1.4.0 от 20 октября ↗ добавлена Qwen3.8-Flash-Next с QSA sparse attention. Поддержаны потоковая загрузка экспертов MoE и n-gram-таблицы PLE с SSD, а у Flash-Next — выгрузка активного KV. У 27B и 35B активный KV остаётся в RAM.
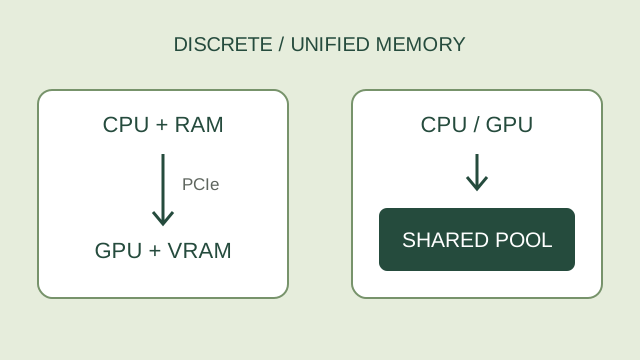
Это полезно, когда весь рабочий набор не помещается в общий пул Mac: часть данных движок подчитывает с накопителя. Перед выбором более мелкого кванта теперь можно сравнить режим с SSD на своей задаче. Начинайте с обычного окна и короткого запроса: большой допустимый контекст сам по себе не делает длинный документ удобным в работе.
Требования и установка
README версии 1.4.0 указывает Apple M3 или новее и macOS 26.4+. Для приведённых 4-битных примеров нужно от 36 ГБ общей памяти, рекомендовано 48 ГБ; для Mac на 24 ГБ предусмотрены меньшие GGUF. Это требования конкретного пути запуска, а не всех движков на Mac. Если Homebrew уже установлен, в Terminal:
brew install incoai/tap/splash
splash --version
splash serve --help
Если Splash установлен, сначала остановите сервер через Ctrl+C, затем выполните brew update и brew upgrade incoai/tap/splash. Запишите получившуюся версию: Homebrew устанавливает доступную ему сборку, а этот разбор привязан к 1.4.0. Для старых моделей удобен базовый текстовый запуск:
splash serve --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M --language-only --max-context 8192Первая загрузка скачивает модель и соответствующий DFlash2 draft. После Ready откройте http://127.0.0.1:8000. В этой версии прежние пакеты incoai/*-Splash больше не загружаются: используйте upstream GGUF или поддержанный MLX. Интеграция LM Studio Bionic ↗ управляет своим runtime; номер отдельного CLI не подтверждает версию встроенного движка.
Память Flash-Next и ресурс SSD
Общие 36 ГБ (48 ГБ рекомендовано) из README относятся к приведённым 4-битным примерам 27B/35B. Для Flash-Next Q2_0 релиз показывает M5 Pro с 64 ГБ; другой пример потоковых экспертов с хранилищем 12G — M5 Max с 36 ГБ. Это документированные конфигурации, а единый минимальный объём RAM для Flash-Next, всех окон и режимов 1M разработчик не задаёт. Для выбранного GGUF смотрите план памяти при старте: нужны место для draft, индекса и горячего KV, а также SSD-квота.
Streaming экспертов и PLE читает исходные веса с SSD; Splash не создаёт дополнительную копию весов на диске. Выгрузка KV и состояний пишет кэш на SSD и расходует ресурс записи накопителя. По документации --max-cache-disk-writes 200G задаёт средний бюджет записи в день; это регулирование, а не жёсткий суточный потолок: нужные для продолжения состояния и KV могут пройти сверх бюджета. По умолчанию бюджет записи выключен, а --max-cache-disk 0 выключает SSD-кэш; streaming весов настраивается отдельно.
Первый запуск Flash-Next
splash serve --model ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:Q2_0 --language-only --max-context 8192Это конкретный GGUF из примера релиза, а не произвольная модель с названием Flash. У Flash-Next в 1.4.0 поддержаны GGUF, но не MLX. Сначала проверьте автоматический план памяти. Параметры версии 1.4.0 ↗ позволяют ограничивать отдельные хранилища:
| Параметр | Назначение |
|---|---|
--max-memory 28G | Потолок Metal-выделений; не вся память процесса |
--expert-memory 12G | RAM-хранилище экспертов MoE, остальные подчитываются с SSD |
--ple-memory 512M | Строковый кэш PLE Flash-Next |
--sparse-kv-memory 1200M | Горячие блоки выгруженного KV Flash-Next |
--max-cache-disk 16G | Квота дискового кэша |
Числа в таблице — примеры синтаксиса, не подобранная конфигурация вашего Mac. Комбинируйте ограничения после пробного запуска, оставляя память ОС и приложениям. Значение off у --expert-memory и --ple-memory загружает все соответствующие данные, а не отключает их. Выгрузке KV нужен доступный для записи SSD-кэш.
Почему 1M не равно нашему пресету 256K
Для поддержанных семейств релиз разрешает выход за исходные 262 144 токена через static YaRN: --max-context 1M означает 1 000 000 токенов. Это меняет выходы модели даже на коротких запросах. Сначала проверяйте качество на своём материале.
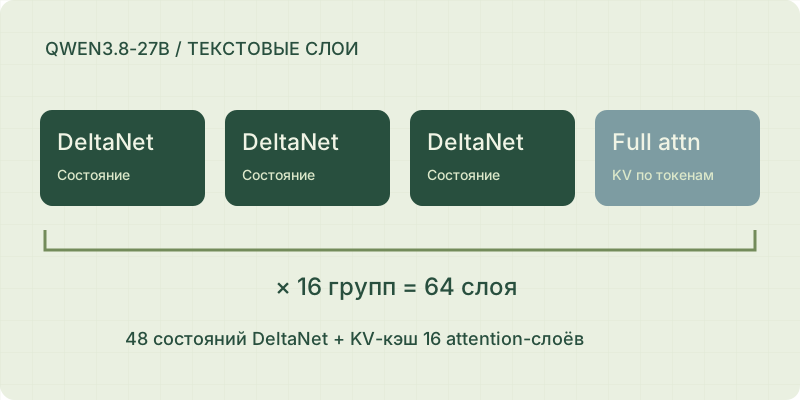
В калькуляторе остаются проверенные текстовые профили Qwen3.8-27B и Qwen3.6-35B-A3B с прежним лимитом. Они считают все языковые веса в памяти, обычный KV и одну копию состояний. Они не моделируют SSD streaming, draft, дополнительные снимки для prefix cache и бюджет планировщика Splash. Flash-Next по-прежнему указана без численного пресета: появление runtime не устраняет отличия её архитектуры.
Как сравнить с прежним движком
- Запишите Mac, общий объём памяти, версию Splash, точный GGUF и параметры памяти. Отдельно отметьте, включилась ли потоковая загрузка с SSD.
- Возьмите один короткий запрос и один реальный документ. Сравните холодную загрузку, время первого ответа и генерацию после обработки входа.
- Повторите запрос с общим префиксом, затем с другим документом. Повторное использование кэша и чтение нового входа — разные нагрузки.
- Проверьте диск и память при нескольких запросах; задайте квоту кэша. Если SSD становится ограничением, уменьшите окно или измените размещение экспертов.
В 1.4.0 автоматический выбор строк проверки draft может менять выходы MoE. Для повторяемого сравнения разработчик рекомендует --verify-rows all, изолированные запросы и одинаковые сохранённые префиксы. Следуйте методике измерений. Здесь нет собственных замеров Splash и обещания ускорения: результат зависит от модели, кванта, окна, кэша и накопителя.
Источники и документация
- Inco AI, 20.10.2026: Splash 1.4.0 ↗
- Inco AI: требования и запуск, README именно 1.4.0 ↗
- Inco AI: настройки, удаление старых пакетов и память, документация 1.4.0 ↗
- Inco AI: план памяти и активный KV на SSD, PR #481 ↗
- Inco AI: Flash-Next и YaRN, PR #469 ↗
- Inco AI, Splash 1.0.2: порядок обновления через Homebrew ↗
- LM Studio Team, 18.09.2026: интеграция Splash в Bionic ↗
Сведения и документация проверены 25.10.2026.