Начните с модели и контекста
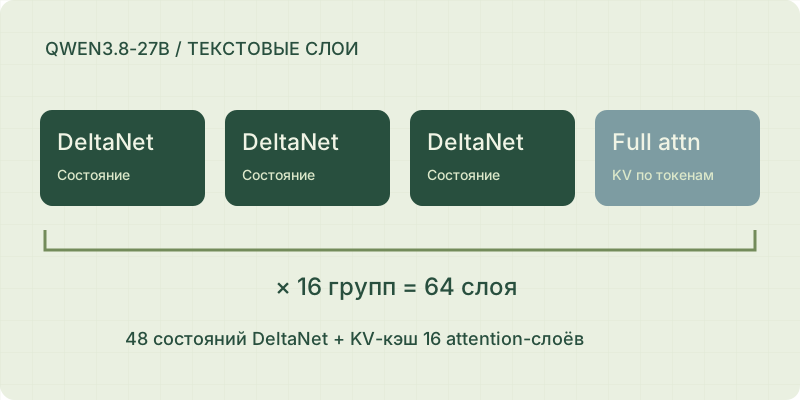
Размер загрузки — это место на диске. При запуске добавляются KV-кэш, состояния гибридных слоёв и рабочие буферы. Для выбора GPU сначала задайте модель, квантование и длину окна: короткий чат и анализ документов требуют разного бюджета.
Сценарии по объёму VRAM
| VRAM | Модель | Контекст | Веса | KV + состояния | Всего |
|---|---|---|---|---|---|
| 8 ГБ | Qwen3.5 4B | 8K | 2,28 ГиБ | 0,3 ГиБ | 4,08 ГиБ |
| 8 ГБ | Qwen3.5 9B | 32K | 5,13 ГиБ | 1,05 ГиБ | 7,68 ГиБ |
| 16 ГБ | Qwen3 14B | 32K | 8,44 ГиБ | 5,0 ГиБ | 14,94 ГиБ |
| 24 ГБ | Qwen3.8 27B | 64K | 15,4 ГиБ | 4,14 ГиБ | 21,05 ГиБ |
| 32 ГБ | Qwen3.8 27B | 128K | 15,4 ГиБ | 8,14 ГиБ | 25,05 ГиБ |
Оценки калькулятора для одной текстовой последовательности, все языковые веса на GPU; vision, MTP и пик prefill исключены. Это не гарантия запуска. У малых моделей конкретный GGUF может заметно превышать усреднённую оценку весов.
Когда 24 ГБ оказывается мало
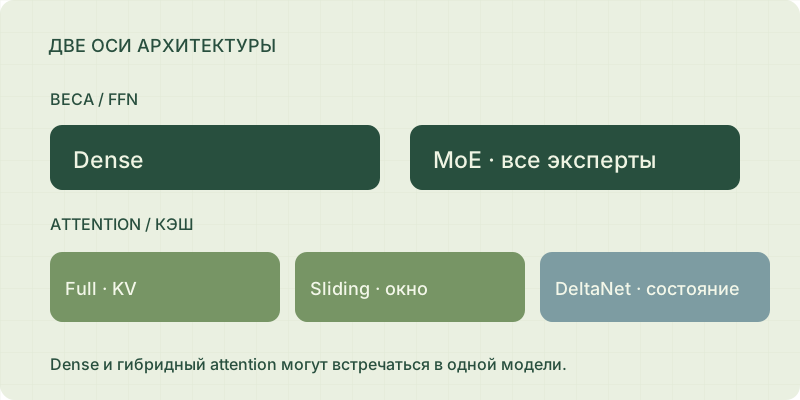
Qwen3.8 27B при 32K требует 19,05 ГиБ, а Qwen3 32B при тех же условиях — 28,21 ГиБ. Разницу создают и веса, и архитектура внимания. У MoE в VRAM нужно разместить всех экспертов, даже когда на токен используется малая часть.
Если модель не помещается, рассмотрите системы с общей памятью: Mac, Strix Halo и DGX Spark.
Параллельный запрос требует отдельного бюджета кэша; вычисления для одного пользователя нельзя автоматически переносить на сервер с несколькими одновременными диалогами.
Что уменьшать при нехватке памяти
- Посмотрите фактический CONTEXT и PROCESSOR в
ollama ps. - Уменьшите окно, затем выберите меньшую модель или квант весов.
- Проверьте возможность квантованного KV по плану диагностики.
- Если нужен offload, измерьте скорость обработки длинного запроса до покупки.
Источники и документация
- Qwen3.5 4B: конфигурация ↗
- Qwen3.5 9B: конфигурация ↗
- Qwen3 14B: конфигурация ↗
- Qwen3.8 27B: конфигурация ↗
- Qwen3 32B: конфигурация ↗
- Ollama: контекст по объёму VRAM ↗
- Ollama: настройки, кэш, хранение моделей ↗
Сведения и документация проверены 25.10.2026.