Модель
Обученная нейросеть с весами. Обрабатывает предоставленный вход и формирует текст или запрос на действие.
ПримерQwen, Llama, gpt-oss
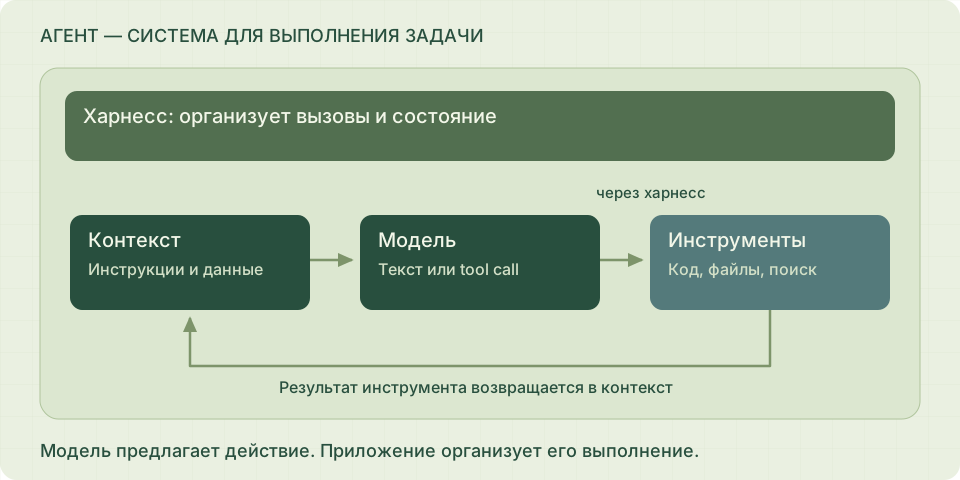
Модель, агент, харнесс и инструменты — разные роли в одной системе. Разберём их на схемах, затем пройдём один запрос по шагам.
Принципы работы · обновлено · оригинальные схемы редакцииРасчёт шага 6: Q4_K_M, текст без vision/MTP и пика prefill. Параметры · Контекст Ollama по VRAM · Архитектура модели.
GPU, MCP и инструменты в трёх сценариях.
Обученная нейросеть с весами. Обрабатывает предоставленный вход и формирует текст или запрос на действие.
Система, которая использует модель для выбора шагов к цели и учитывает результаты действий.
Управляющая программная обвязка: готовит контекст, вызывает модель и инструменты, хранит состояние, ограничивает цикл.
Сценарий записан заранее. Кнопки переключают объяснения: на этой странице модель, поиск и доступ к вашим файлам не запускаются. Это схема обмена данными, а не внутренние рассуждения нейросети.
Пользователь просит найти конфигурацию своего компьютера в заметках и подсказать, с чего начать. Модель ещё не получила содержимое файлов.
Что важно: Задача задаёт желаемый результат. Для чтения заметок понадобится предоставленный приложением инструмент.
«Найди в моих заметках объём RAM и VRAM моего ПК. Объясни, с какой локальной модели начать».Приложение собирает инструкции, вопрос и описание функции поиска. Файлы не передаются целиком: модель сначала узнаёт, какой инструмент доступен.
Что важно: Модель видит подготовленный вход, а не весь диск или всю память компьютера.
Инструкции: отвечать по найденным данным, отмечать неизвестное.
Вопрос: найти характеристики ПК.
Инструмент: search_notes(query) — поиск по заметкам пользователя.В этом записанном сценарии модель выбирает поиск и формирует запрос с именем инструмента и аргументами. Это предложение действия, а не выполненное чтение.
Что важно: Формат здесь условный. В реальном приложении он зависит от API, шаблона чата и поддержки tool calling.
{
  "name": "search_notes",
  "arguments": {"query": "конфигурация моего ПК RAM VRAM"}
}Харнесс сопоставляет имя с функцией, проверяет аргументы и доступ к заметкам. Инструмент выполняет поиск и возвращает фрагмент с источником. На этой странице вместо запуска показан заранее записанный результат.
Что важно: Файлы читает программный инструмент. Если операция завершается ошибкой, в следующем шаге нужно учитывать ошибку, а не выдумывать результат.
Источник: notes/pc.txt
RAM: 32 ГБ
Видеокарта: 16 ГБ выделенной VRAM
Точная модель GPU в заметке не указана.Приложение добавляет запрос инструмента и его результат к истории и снова вызывает модель. Теперь во входе есть числа из заметки, а не только описание функции поиска.
Что важно: Так возникает обратная связь. Следующим выходом может быть ещё один запрос инструмента, уточнение пользователю или ответ.
Контекст следующего вызова:
1. Инструкции и исходный вопрос
2. Запрос search_notes(...)
3. Результат из notes/pc.txt

Веса модели остаются теми же.В нашем примере модель формирует ответ по полученным данным, а харнесс завершает выполнение. Здесь было два вызова модели и один условный вызов инструмента — в других задачах число шагов отличается.
Что важно: Ответ опирается на наблюдение и сохраняет неопределённость там, где данных не было.
«В notes/pc.txt указаны 32 ГБ RAM и 16 ГБ VRAM. Qwen3 14B Q4_K_M с окном 8192, KV FP16 и резервом 1,5 ГиБ требует по калькулятору 11,19 ГиБ. В Ollama задайте /set parameter num_ctx 8192 и проверьте CONTEXT в ollama ps: по умолчанию на 16 ГиБ окно 4K. Точная модель GPU не указана, совместимость приложения проверьте по ней».Три интерактивных сценария: подбор GPU, поиск по договорам с субагентом и исправление теста. На карте видны MCP, встроенные инструменты, диск, сеть и память модели.
Открыть интерактивную схему ↗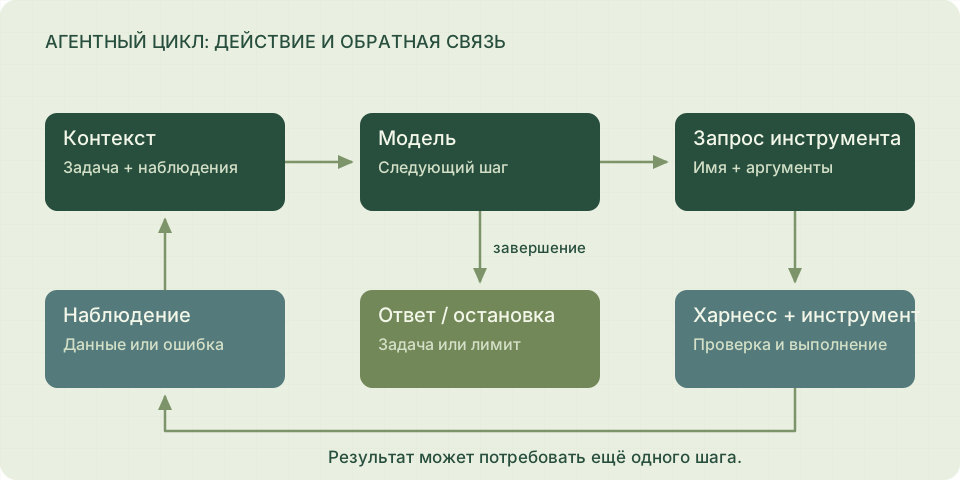
Чат, файлы и настройки. В агентном сценарии здесь или в связанном сервисе работает харнесс.
Загружает веса, выполняет вычисления, ведёт кэш. Примеры — llama.cpp и реализации моделей в Transformers.
Исполняют операции и хранят данные. Размещение зависит от движка, доступной VRAM и настроек.
Как найти задержку между вызовами: смотрите длительность каждого этапа журнала.
Память параллельных слотов — в цифрах.
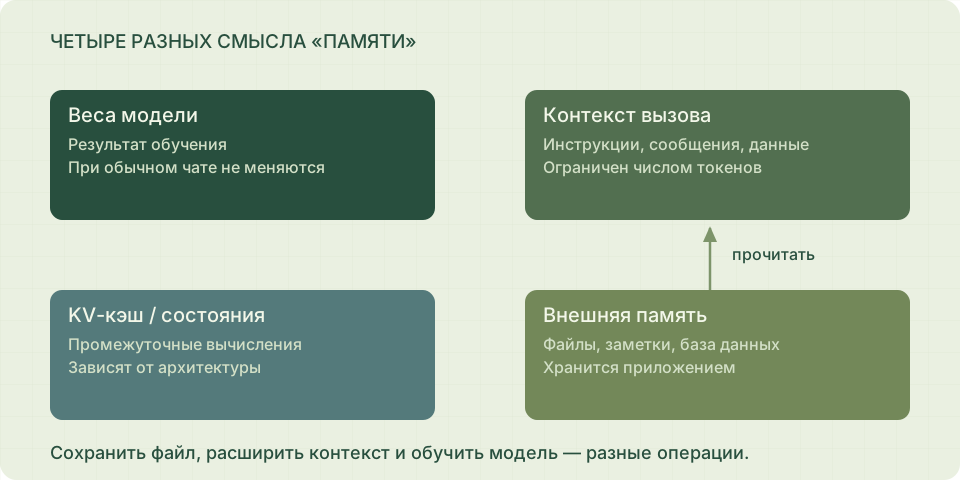
Что происходит внутри вызова модели ↗Изученные закономерности. При обычном инференсе не переписываются после каждого ответа.
Инструкции, история, вопрос и подставленные данные. Имеет ограниченный размер.
Промежуточные данные attention для повторного использования. Как хранить историю.
Файлы, заметки и базы. Их нужно прочитать и включить нужные сведения в контекст.
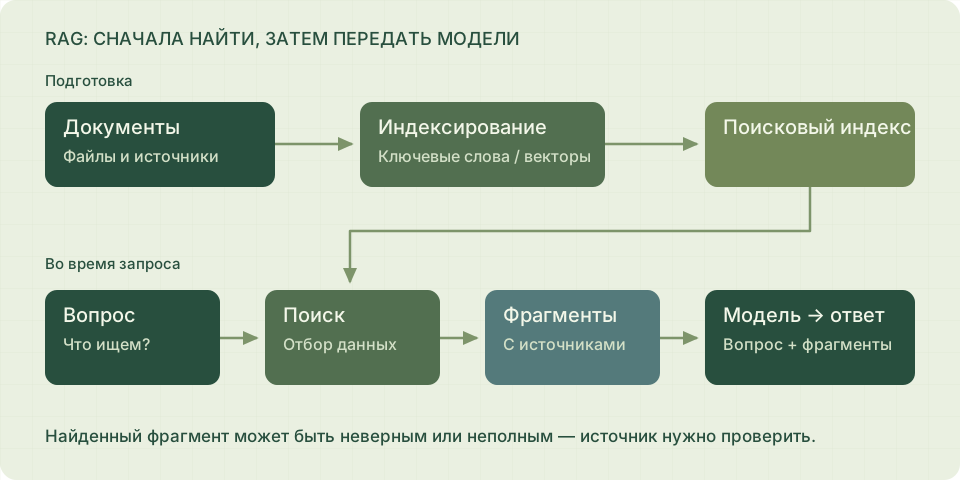
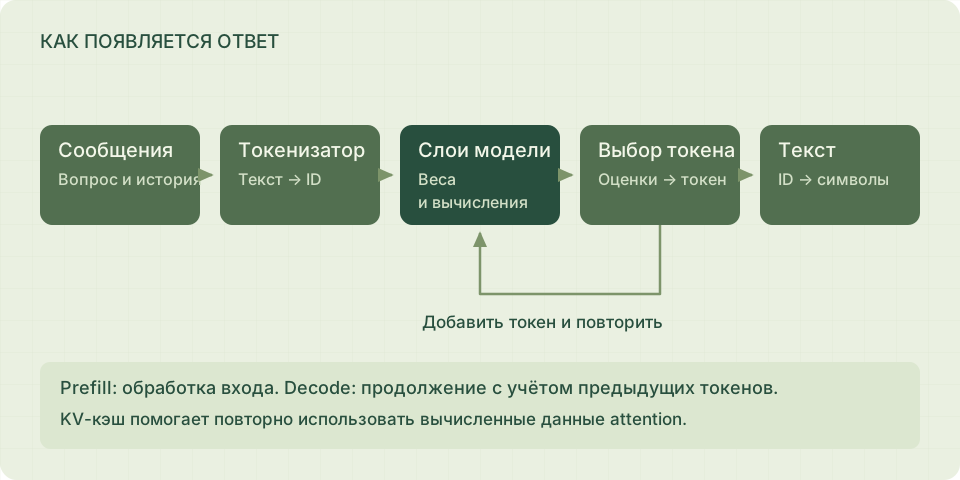
Токенизация, prefill, decode и KV-кэш на примере Qwen3 8B. Где GPU ускоряет вычисления и где заканчивается расчётный потолок.
Разбираем запрос инструмента, журнал цикла и память параллельного агента на локальном сервере.
Почему агент теряет детали, сколько кэша добавляют найденные фрагменты и как вынести embeddings на CPU.
Нет. Агентный цикл может использовать одну модель многократно. Разные роли и разные инструкции не обязательно означают разные наборы весов.
Нет. Приложение должно предоставить подходящий инструмент, получить запрос на его вызов и выполнить операцию с имеющимися правами. Описание инструмента не равно содержимому файлов.
Не обязательно. Сама генерация может выполняться локально, а инструменты поиска, внешние API или другие функции приложения — обращаться к сети. Это проверяется для конкретной конфигурации.
Большая VRAM помогает разместить модель и кэш, а подходящий GPU может ускорить вычисления. Качество модели, подбор контекста, логика харнесса и работа инструментов требуют отдельной проверки.
Самостоятельные учебные материалы редакции. Схемы упрощают устройство системы; детали зависят от архитектуры модели и реализации приложения.