Из текста в числа
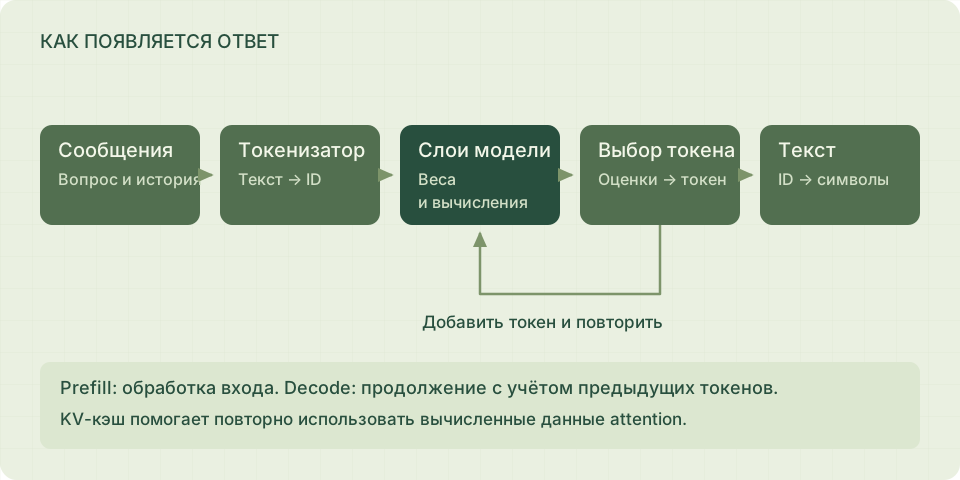
Токенизатор разбивает вход на элементы словаря. По их идентификаторам модель выбирает начальные векторы и обрабатывает последовательность слоями. На выходе получаются оценки следующего токена; правило выбора использует настройки генерации. Выбранный токен добавляется к последовательности, затем цикл повторяется.
Prefill и decode
Prefill обрабатывает уже известный вход: системный текст, историю и документ. Decode добавляет ответ по одному токену; новый шаг использует ранее рассчитанные данные attention. Поэтому время до первого токена и скорость дальнейшей печати — разные показатели. Для длинного документа быстрый decode не компенсирует медленный prefill.
Где помогает видеокарта
Для одного dense decode-токена приближённо нужно прочитать веса. У Qwen3 8B Q4_K_M их расчётный размер 4,68 ГиБ. Если считать только это чтение, потолок равен пропускная способность / размер весов:
| Карта | Память, ГБ/с | Потолок, токенов/с |
|---|---|---|
| GeForce RTX 5060 Ti 16 ГБ | 448 | 89 |
| GeForce RTX 3090 | 936 | 186 |
| GeForce RTX 5090 | 1792 | 356 |
Числитель переведён из десятичных ГБ/с в байты, знаменатель — из ГиБ. Эта граница предполагает идеальное использование памяти и одно чтение весов; она исключает чтение KV, операции и накладные расходы. Реальный движок работает медленнее. Prefill обрабатывает много токенов параллельно и сильнее использует вычислительную часть GPU. Как измерять обе стадии.
KV-кэш в числах
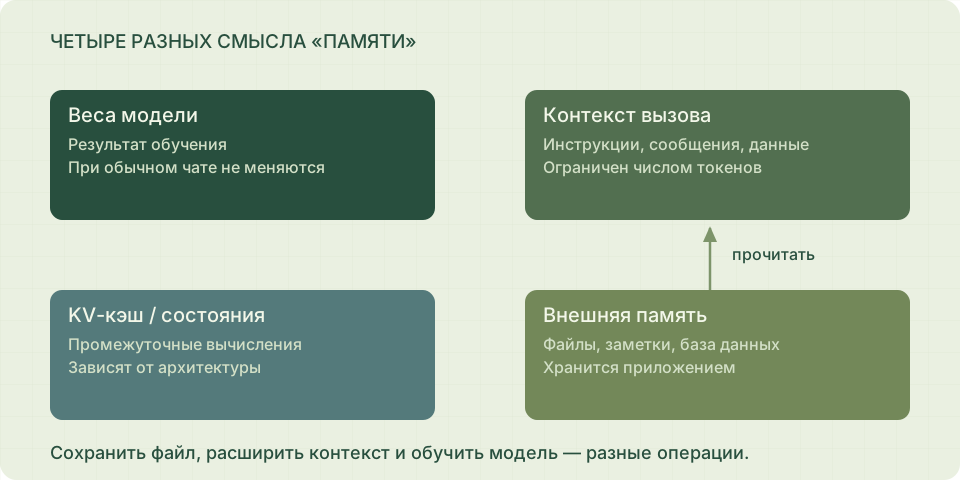
Формула для обычного внимания: 2 × слои × KV-головы × размер головы × токены × байты. Qwen3 8B в FP16 требует 144 КиБ на токен; на 8K — 1,13 ГиБ, на 32K — 4,5 ГиБ. Веса при этом остаются 4,68 ГиБ в оценке Q4_K_M.
Не нужно пересчитывать ключи и значения всех прошлых токенов на каждом шаге. Схемы хранения гибридного внимания отличаются: архитектуры и формулы.
Кто организует запуск
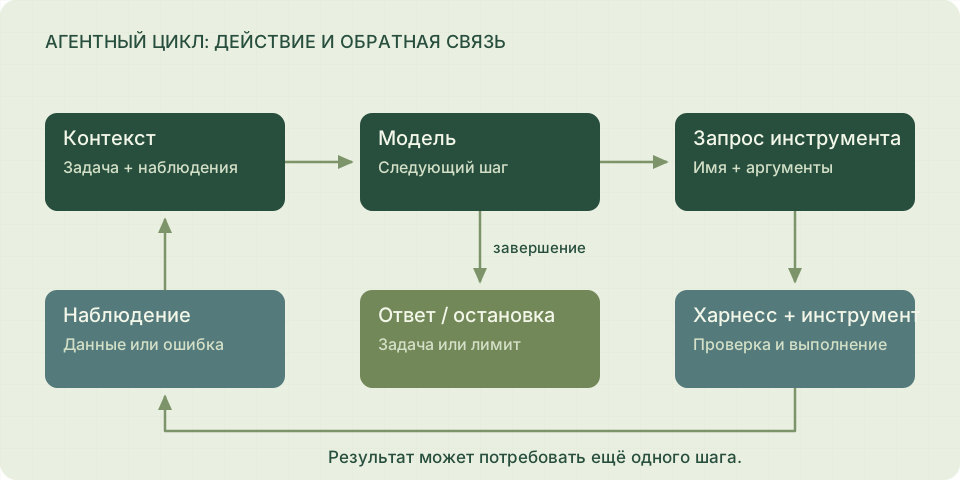
Приложение собирает вход, движок выполняет модель. Карта ролей — в разделе принципов; управление инструментами и циклом — в статье о харнессе. Здесь рассматриваются вычисления одного вызова.
Источники и документация
- Hugging Face Transformers: генерация текста ↗
- Hugging Face Transformers: как работает KV-кэш ↗
- Qwen3 8B: конфигурация ↗
- GeForce RTX 5090: спецификация памяти ↗
- GeForce RTX 5060 Ti 16 ГБ: спецификация памяти ↗
- GeForce RTX 3090: спецификация памяти ↗
Сведения и документация проверены 24.10.2026.