Что это за модель
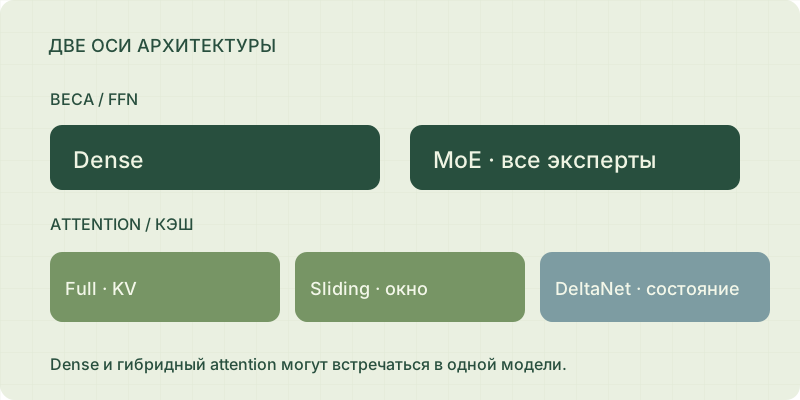
Qwen3.8-27B — dense vision-language модель на основе архитектуры Qwen3.5. Это самостоятельное поколение, а не запись «Qwen3 8B» без пробела. Карточка содержит Transformers-веса и описывает запуск через Transformers, vLLM, SGLang и TokenSpeed; готовый GGUF и его поддержку нужно проверять у поставщика и движка отдельно.
Для Mac есть специализированный Splash 1.4.0: Qwen3.8-27B запускается из поддержанного GGUF или MLX, Flash-Next добавлена отдельным путём. Веса draft, снимки prefix cache и SSD streaming не входят в таблицы этой статьи; их нужно учитывать по плану памяти runtime.
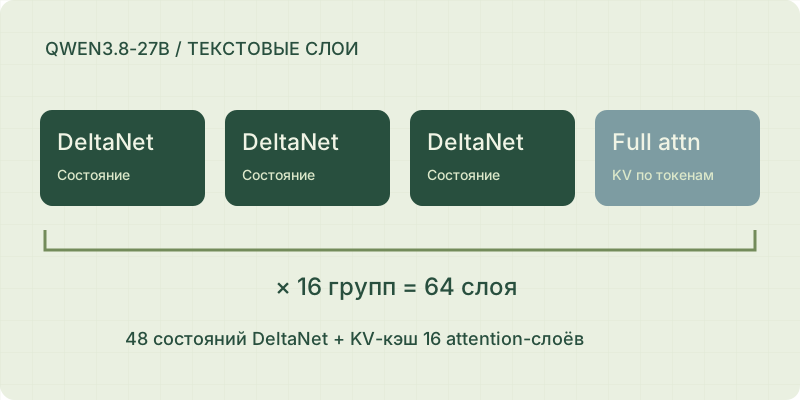
16 обычных слоёв и 48 DeltaNet
У текстового пресета 64 слоёв: 16 full attention и 48 DeltaNet, KV-головы 4 × 256. На 8K обычный KV FP16 занимает 0,5 ГиБ, состояния — 0,14 ГиБ. Состояния в референсном сценарии фиксированы по длине; они не уменьшаются при выборе Q8 для KV.
Что помещается на одной карте
| VRAM | Максимум KV FP16 | Расход | Максимум KV Q8 | Расход |
|---|---|---|---|---|
| 16 ГБ | Не помещается | 17,3 ГиБ | Не помещается | 17,18 ГиБ |
| 24 ГБ | 64K | 21,05 ГиБ | 128K | 21,3 ГиБ |
| 32 ГБ | 128K | 25,05 ГиБ | 256K | 25,55 ГиБ |
| 96 ГБ | 256K | 33,05 ГиБ | 256K | 25,55 ГиБ |
Максимум из ряда 4K–256K в пределах пресета. Если не помещается даже 4K, указан расход на 4K. Это оценка хранения одной текстовой последовательности без vision, MTP и пика prefill; не гарантия запуска. Квантованный KV требует поддержки архитектуры и бэкенда. Проверить 24 ГБ.
Из чего складывается бюджет
| Контекст | Веса | KV | Состояния | Всего |
|---|---|---|---|---|
| 4K | 15,4 ГиБ | 0,25 ГиБ | 0,14 ГиБ | 17,3 ГиБ |
| 8K | 15,4 ГиБ | 0,5 ГиБ | 0,14 ГиБ | 17,55 ГиБ |
| 32K | 15,4 ГиБ | 2,0 ГиБ | 0,14 ГиБ | 19,05 ГиБ |
| 64K | 15,4 ГиБ | 4,0 ГиБ | 0,14 ГиБ | 21,05 ГиБ |
| 128K | 15,4 ГиБ | 8,0 ГиБ | 0,14 ГиБ | 25,05 ГиБ |
| 256K | 15,4 ГиБ | 16,0 ГиБ | 0,14 ГиБ | 33,05 ГиБ |
Для KV используется 2 × full-attention слои × KV-головы × размер головы × контекст × байты. Состояние DeltaNet — одна рекуррентная FP32-матрица и 16-битный буфер свёртки на линейный слой. Дополнительные копии состояний движка сюда не входят.
Thinking и маленькое окно
В карточке thinking включён по умолчанию; preserve_thinking сохраняет блоки рассуждения истории и тоже включён. В локальном Jinja-шаблоне его отключают через chat_template_kwargs; облачный API в карточке использует другой способ передачи. Эти поля не являются универсальными CLI-флагами Ollama.
Авторы рекомендуют для агентных задач большое место под вывод: до 262 144 токенов рассуждения и 131 072 финального ответа в описанном сценарии окна 1M. Это рекомендация для поддерживающих такой режим фреймворков, а не размер нашего пресета: локальное нативное окно указано 262 144. Строки 4K/8K показывают лишь размещение памяти и оставляют мало места для длинного reasoning вместе со входом.
Порядок запуска
- Уточните поставку весов и поддержку Qwen3.8 в конкретном runtime.
- Сначала задайте текстовый режим и окно, проверьте фактически загруженный vision.
- Проверьте thinking и шаблон диалога по рекомендациям поставщика.
- Измерьте время обработки документов отдельно от генерации.
Qwen3.8-Flash-Next и другие модели семейства не наследуют этот численный пресет: область покрытия.
Источники и документация
- Inco AI, 20.10.2026: поддержанные модели Splash 1.4.0 ↗
- Qwen: карточка Qwen3.8-27B ↗
- Qwen3.8 27B: конфигурация ↗
- Transformers: DeltaNet ↗
- Transformers: кэш ↗
Сведения и документация проверены 25.10.2026.